Data engineering
Data engineering zorgt dat je gegevens klaar zijn voor rapportages en AI. We halen gegevens uit je webshop, boekhouding, ERP en andere systemen, maken ze schoon, leggen ze op één plek en houden ze automatisch actueel. Voor bedrijven waar cijfers nu met de hand uit exports worden samengevoegd, of waar een AI-project vastloopt omdat de gegevens niet kloppen. Het levert één betrouwbare bron op, zonder handwerk.
In het kort
Het probleem
Dat horen we vaak. De omzet in de webshop is anders dan in de boekhouding. De voorraad in het magazijnsysteem klopt niet met wat er ligt. Elke maand maakt iemand een rapportage door exports uit drie systemen in Excel samen te voegen, en elke maand kost dat een dag. Als er een vraag komt die niet in de standaardrapportage staat, duurt het een week voordat er een antwoord is.
Met AI wordt dat probleem groter. Een AI-toepassing die voorraad voorspelt of klantvragen beantwoordt, is zo goed als de gegevens die hij krijgt. Staan klanten dubbel in het systeem, missen kostprijzen of zijn productnamen overal anders, dan zijn de uitkomsten ook niet te vertrouwen. Veel AI-projecten lopen daarop vast, lees meer in waarom AI-projecten vastlopen.
Uitleg
Data engineering is het werk achter de schermen dat zorgt dat gegevens bruikbaar zijn. Het bestaat uit drie delen:
Een datapijplijn is de reeks stappen die dat automatisch doet, bijvoorbeeld elk uur of elke nacht. Data readiness is de vraag of je gegevens goed genoeg zijn voor wat je ermee wilt. Een AI audit kijkt daar onder meer naar.
Oplevering
01
Automatische koppelingen met je webshop, boekhouding, ERP, CRM en andere systemen, via hun API of database.
Lees meer02
Een database of datawarehouse waar alle gegevens samenkomen, schoon en met vaste afspraken over wat elk cijfer betekent.
Lees meer03
Controles die melden als een koppeling faalt, gegevens ontbreken of cijfers ineens afwijken.
Lees meer04
Gegevens in een vorm die voorspellingen, agents en AI-assistenten kunnen gebruiken, met toegangsregels.
Lees meerWerkwijze
Voorbeeld
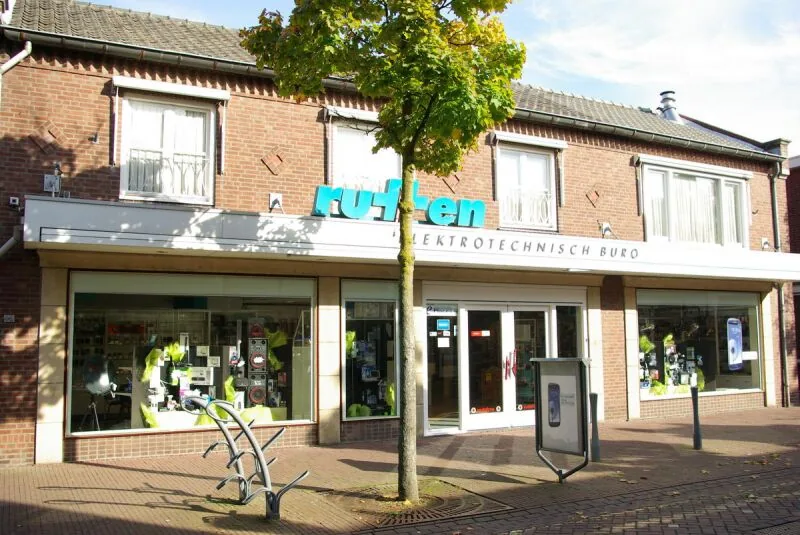
Bij Rutten Elektroshop staan ruim 9.750 artikelen online en in de winkel. We koppelden de systemen zo dat kostprijzen automatisch aan de artikelen gekoppeld worden. Daardoor is de voorraadwaarde realtime zichtbaar, en kan het systeem voorspellen wanneer een artikel op is en een inkoopadvies geven. Klantcontact uit WhatsApp en mail komt op één plek.
Bij Candy Online, met meer dan 4.000 artikelen, zijn marge en voorraadwaarde realtime inzichtelijk. Dat kan alleen als de gegevens uit webshop, inkoop en voorraad goed aan elkaar gekoppeld zijn.
In beide gevallen was het meeste werk onzichtbaar: gegevens gelijktrekken, afspraken maken over wat leidend is en koppelingen bouwen die blijven lopen. Het dashboard en de voorspelling zijn daarna het makkelijke deel.
Kosten
De prijs hangt af van het aantal systemen, de kwaliteit van de gegevens, hoe vaak ze ververst moeten worden en wat je ermee wilt. Een koppeling tussen webshop en boekhouding voor een omzetrapportage is iets anders dan vijf systemen samenvoegen voor een voorspelmodel.
We werken met een vaste prijs per afgesproken stap, met functionaliteiten en acceptatiecriteria vooraf. Kost het ons meer tijd dan ingeschat, dan dragen wij dat binnen de scope. Lost de opgeleverde kernfunctionaliteit het vooraf omschreven probleem niet op, dan betaal je niet voor die oplossing. Na de oplevering houden we de pijplijnen in beheer. prijsindicatie data engineering en beheer per maand
Weet je nog niet welke gegevens je nodig hebt, begin dan met een AI audit of een kansenonderzoek.
Veiligheid
Als alle gegevens op één plek staan, moet die plek goed beveiligd zijn. We werken met toegangsbeheer, zodat iedereen alleen ziet wat hij nodig heeft, en met logging van wie wat opvraagt. Persoonsgegevens nemen we alleen mee als dat nodig is, en waar het kan geanonimiseerd.
De gegevens, de pijplijnen en de code zijn van jou. We bouwen op Europese hosting waar passend, of op je eigen server. Stop je met ons, dan draaien de pijplijnen door en kun je alles meenemen. Meer over hoe we daarmee omgaan lees je bij veiligheid en governance.
Klantverhaal
Retail
70 jaar elektrozaak. Voorraad, kostprijzen en prijsadvies uit één systeem, het winkelgevoel bleef.
9.750+ artikelen live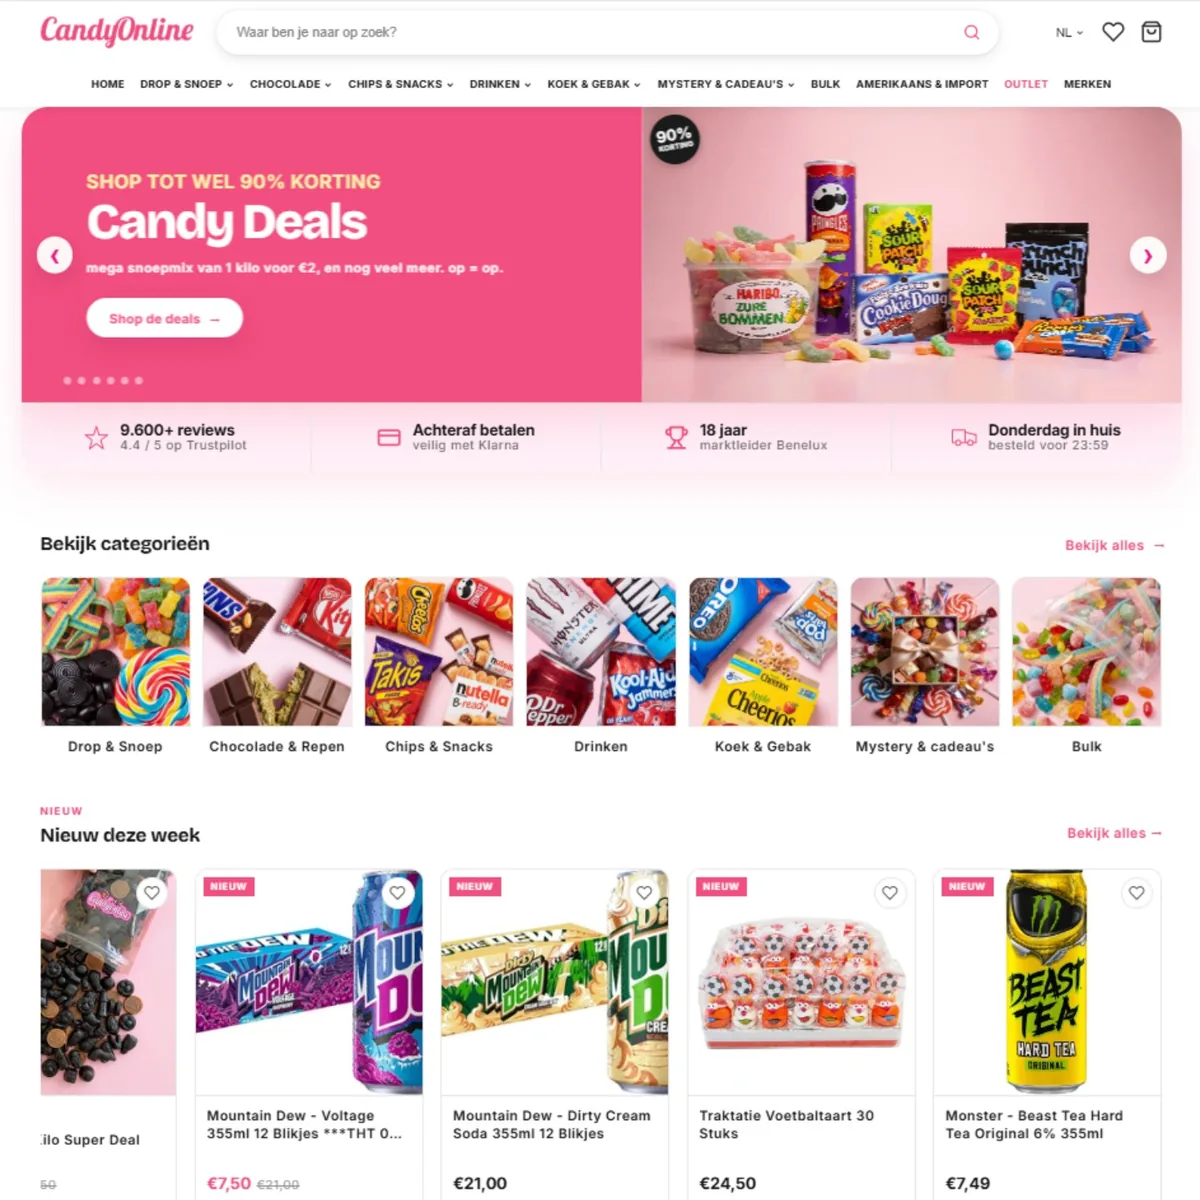
E-commerce
De oudste snoepwebshop van Nederland. Voorraad, backorders, klantenservice en boekhouding geautomatiseerd.
75% minder personeelVoor onderzoek, ontwikkeling en scholing zijn er landelijke en regionale regelingen. We checken welke bij jouw plan passen.
Veelgestelde vragen
Dat hangt af van het aantal systemen, de kwaliteit van de gegevens en wat je ermee wilt. We spreken een vaste prijs per stap af, met acceptatiecriteria vooraf, en daarna een bedrag voor beheer. prijsindicatie data engineering en beheer per maand Vaak beginnen we met één vraag en twee of drie systemen.
Een eerste koppeling met een rapportage kan snel staan. Hoe lang het geheel duurt, hangt vooral af van de kwaliteit van de gegevens en hoeveel systemen er zijn. gebruikelijke doorlooptijd eerste datapijplijn In het eerste gesprek maken we een planning.
Meestal wel. De meeste moderne systemen hebben een API, zoals Shopify, Exact Online, Moneybird en veel CRM- en ERP-pakketten. Heeft een systeem geen API, dan werken we met een database-koppeling of een automatische export. Dat bekijken we in de eerste stap.
Nee. Perfecte gegevens bestaan niet. We bekijken wat goed genoeg is voor de vraag die je wilt beantwoorden, ruimen op wat nodig is en bouwen controles in die fouten zichtbaar maken. Zo worden de gegevens gaandeweg beter.
Plan een strategiegesprek, dan bespreken we welke vragen je wilt beantwoorden en welke systemen daarvoor gekoppeld moeten worden.
